11分 vs 111分。CodexとClaude Codeに同じ実務を丸投げして分かった使い分け
2026/10/20 03:00 公開
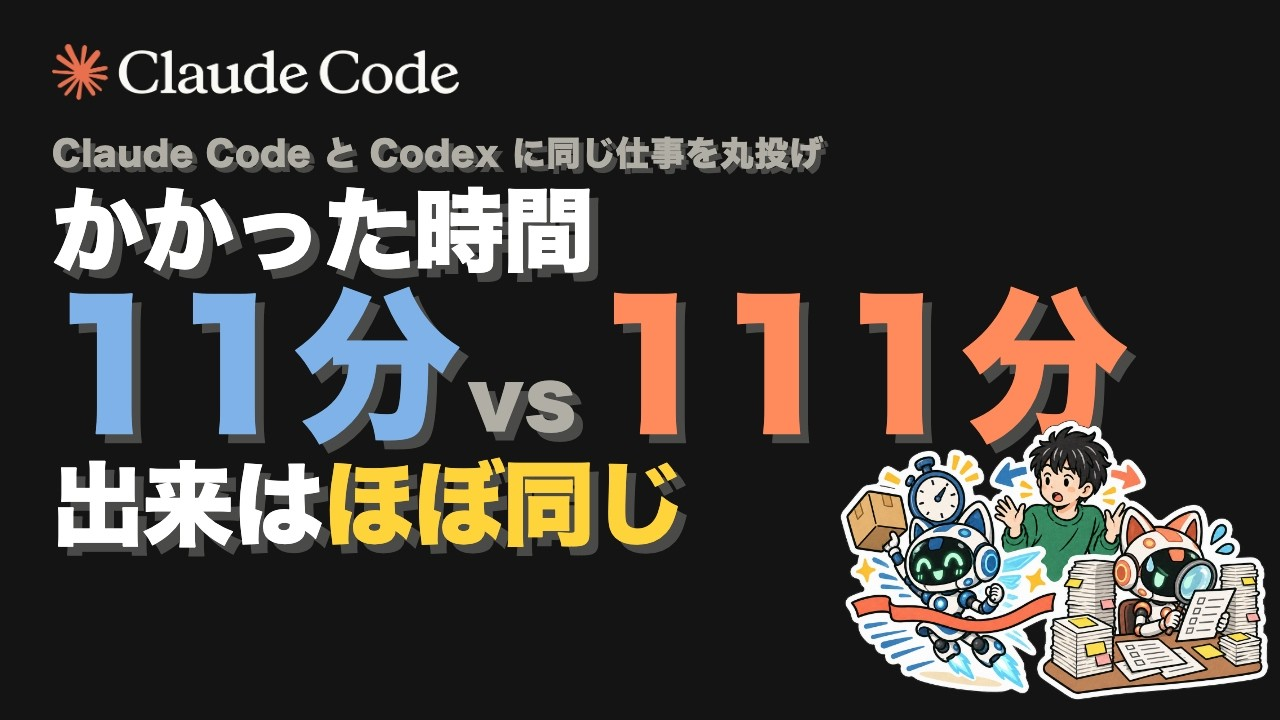
CodexとClaude Codeに、一字一句同じ指示で実務を3本投げて比べました。結果から書くと、速さはCodexの圧勝、出来の差は小さい、性格ははっきり違うです。どちらが上かより、「作らせる側と確かめさせる側を別のエンジンにする」のがいちばん効きました。
各ラウンド1回だけの計測(n=1)なので、数字は傾向として読んでください。
先に動画で見たい人へ
同じ比較を動画にしています。ログの画面や途中の様子はこちらの方が分かりやすいです。
比べた条件
- Claude Code: Opus 5.5・effort max(claude 2.1.296)
- Codex: GPT-6.1-sol・reasoning effort ultra(codex-cli 0.162.1)
- どちらもサブスクのログインで実行。APIキーの環境変数は両方とも未設定であることを確認しました。Claude側のログも従量課金への超過なしです
- 確認なし・サンドボックスなしで、同時にスタート。作業フォルダは別々
- 指示文には「人は途中で答えられないので、質問せず最後まで自分で判断して」と書きました。人が口を出した回数・AIが質問してきた回数は、両方とも全ラウンド0回
素の状態ではなく、どちらも普段使っている指示ファイルと個人スキルが効いた状態での比較です。
3本の結果
| お題 | Claude Code | Codex |
|---|---|---|
| R1 新しいツールを作る(領収書PDF・画像→CSVのCLI) | 110分47秒 | 10分50秒 |
| R2 既存repoの実バグ修正(概要欄のフッター二重付与) | 20分16秒 | 9分17秒 |
| R3 相手のコードをレビュー(R1の成果物を入れ替え) | 30分06秒 | 14分37秒 |
所要時間は3本ともCodexが短く、約1/10・1/2・1/2でした。
一方、出来はほとんど変わりません。
- R1の受け入れテスト8件は両方8/8。渡していないサンプル3件(9項目)も両方9/9
- 意地悪なサンプル12件(36項目)は、Claudeが36/36、Codexが35/36。Codexは「R8.9.27」という略記の和暦だけ空欄でした
- R3のレビューで、相手の成果物から見つかった不具合はClaude作が17件、Codex作が16件。全件、こちらで再現を確認しました。結論はどちらも「このまま経理には使えない」
性格の違いがいちばん面白かった
Claude Codeは、頼まれていない検証まで広げる
R1でClaudeは、36分05秒の時点で「33件のテストがすべて通った」と報告しています。ところがそこで止まらず、自分で別のエージェントを立てて、新しい架空の領収書で弱点を探し始めました。いわゆるレッドチームです。
92分36秒ごろには「レッドチームの18件で見つかった7件の失敗は、すべて直しました。『HOTEL』『PASTEL』の中のtelを電話番号の見出しと取り違えていました」と返ってきて、完了は110分46秒。粘り強さと時間のコストが両方見えた場面でした。
Codexは、最小限で確実に止まる
R2のCodexは、開始1分34秒で「原因はtrimの後にフッターを無条件で追加していたこと」と言い切り、従来の動きを残したまま、フッターを付けないオプションを足して直しました。
同じバグに、Claudeは「すでにフッターが入っているかを自動で判定する」直し方を選んでいます。オプションを覚えなくていいので便利な反面、本文にnoteのURLなどフッターの1行が含まれていると、黙ってフッターを付けなくなる誤判定が新しく生まれていました。
- Claude: 使う人の手間は減るが、推測で動く
- Codex: 予測どおりに動くが、使う人がオプションを覚える必要がある
どちらが正しいかは場面によります。実際にこの不具合を手で回避したときは、今の概要欄と完全に一致するかを確かめてから書き込む方式を選んだので、考え方としてはCodex寄りでした。
サブスクでも混雑で落ちる
CodexのR2の1回目は、開始6分23秒で「Selected model is at capacity」で失敗しています。作業場所を初期状態に戻して同じ指示で再実行し、上の表は再実行分の数字です。定額プランでも混雑で落ちることはある、というのも実際に起きたことです。
今の使い分け
| こういう仕事 | 任せる先 |
|---|---|
| 仕様とテストが決まっている実装・バグ修正 | Codex |
| 仕様がふわっとしていて「使う人がどう困るか」まで考えてほしい作業 | Claude Code |
| 長時間任せる深掘り(耐久テスト・調査) | Claude Code(時間の上限を指示に書く) |
| レビュー | 作った方と別のエンジン |
Claude Codeは、放っておくと自分で範囲を広げます。時間も比べたい、または早く終わらせたいなら、「◯分で切り上げて」「テストが通ったら終了」を指示に書くのがコツです。
たとえるなら、Codexは「言われたことを速く確実にこなす部下」、Claude Codeは「言われていないことまで気を回す部下」です。
あなたの環境で同じ比較をするなら
Mac miniのような常時起動のマシンは要りません。手元のMacBookでもWindowsでもできます。
- 両方ともサブスクでログインする(Claude Codeは起動して /login、Codexは codex login)
- APIキーの環境変数が残っていないか確認する。残っていると従量課金になることがあります
- お題ごとにフォルダを2つ作り、同じファイルと同じ指示文を入れる
- ターミナルを2つ開いて同時に実行し、所要時間・テストの合否・使用量を比べる
Windowsは、WSL(Ubuntu)を入れるとMacと同じ手順で進められます。PCを置いておけない人は、クラウド版(Web版のClaude CodeとChatGPTのCodex)に同じGitHubのリポジトリをつないで、同じ指示文を貼れば比べられます。
公平に比べるなら、受け入れテストは先に人が書いて両方に同じものを渡し、渡していないサンプルでも採点するのがおすすめです。テストに合わせただけの作り込みを見抜けます。1回だけだと混雑による失敗や当たり外れもあるので、できれば2〜3回やって中央値で比べてください。
「どっちが上か」で選ぶのをやめた
3本やって残ったのは、どちらか一方に寄せる理由ではなく、作らせるのと確かめさせるのを別のエンジンに分けるという運用でした。どちらも相手の成果物から、再現手順つきの不具合を16〜17件見つけています。同じエンジンに作らせて同じエンジンに確かめさせるより、ずっと穴が見つかります。
使ったもの:
- Claude Code(Opus 5.5・effort max)
- Codex(GPT-6.1-sol・reasoning effort ultra)
- どちらも定額のサブスク内で実行(追加課金なし)
Lステップ × AI を同時に使いたい方へ
公式LINEのWebhook、1つしか設定できなくて困っていませんか?
公式LINEでは、Webhookの送信先URLを1つしか設定できません。そのため、Lステップを導入している企業が「DifyでAIチャットボットも動かしたい」「自社システムにもイベントを飛ばしたい」と思っても、Webhookの奪い合いになってしまいます。
結果として、片方を諦めるか、中継サーバーを自前で構築するか——どちらにしても時間とコストがかかる選択を迫られます。
L-Proxyなら、1つのWebhookを複数サービスに同時転送
公式LINEとサービスの間にL-Proxyを挟むだけで、Webhookを好きな数だけ分岐できます。
- Lステップはそのまま、AIチャットボットを追加導入
- 自社の顧客管理システムにもリアルタイムでイベント連携
- 設定はURL貼り替えだけ。コード不要、最短5分で導入
今なら2週間の無料トライアル実施中。クレジットカード不要で、すべての機能をお試しいただけます。